Equipo Ceibot
Cómo calcular el precio de los tokens de ChatGPT
Cuando una empresa incorpora un modelo de lenguaje en un asistente o agente de IA, el consumo se mide normalmente en tokens. Entenderlos permite estimar el coste de cada conversación, elegir un modelo adecuado y detectar qué partes de un flujo están consumiendo más de lo esperado.
Las tarifas y los modelos cambian con frecuencia. Por eso, en lugar de memorizar un precio concreto, conviene saber cómo hacer el cálculo y contrastar siempre las tarifas vigentes en la página oficial de precios de OpenAI.
Qué es un token
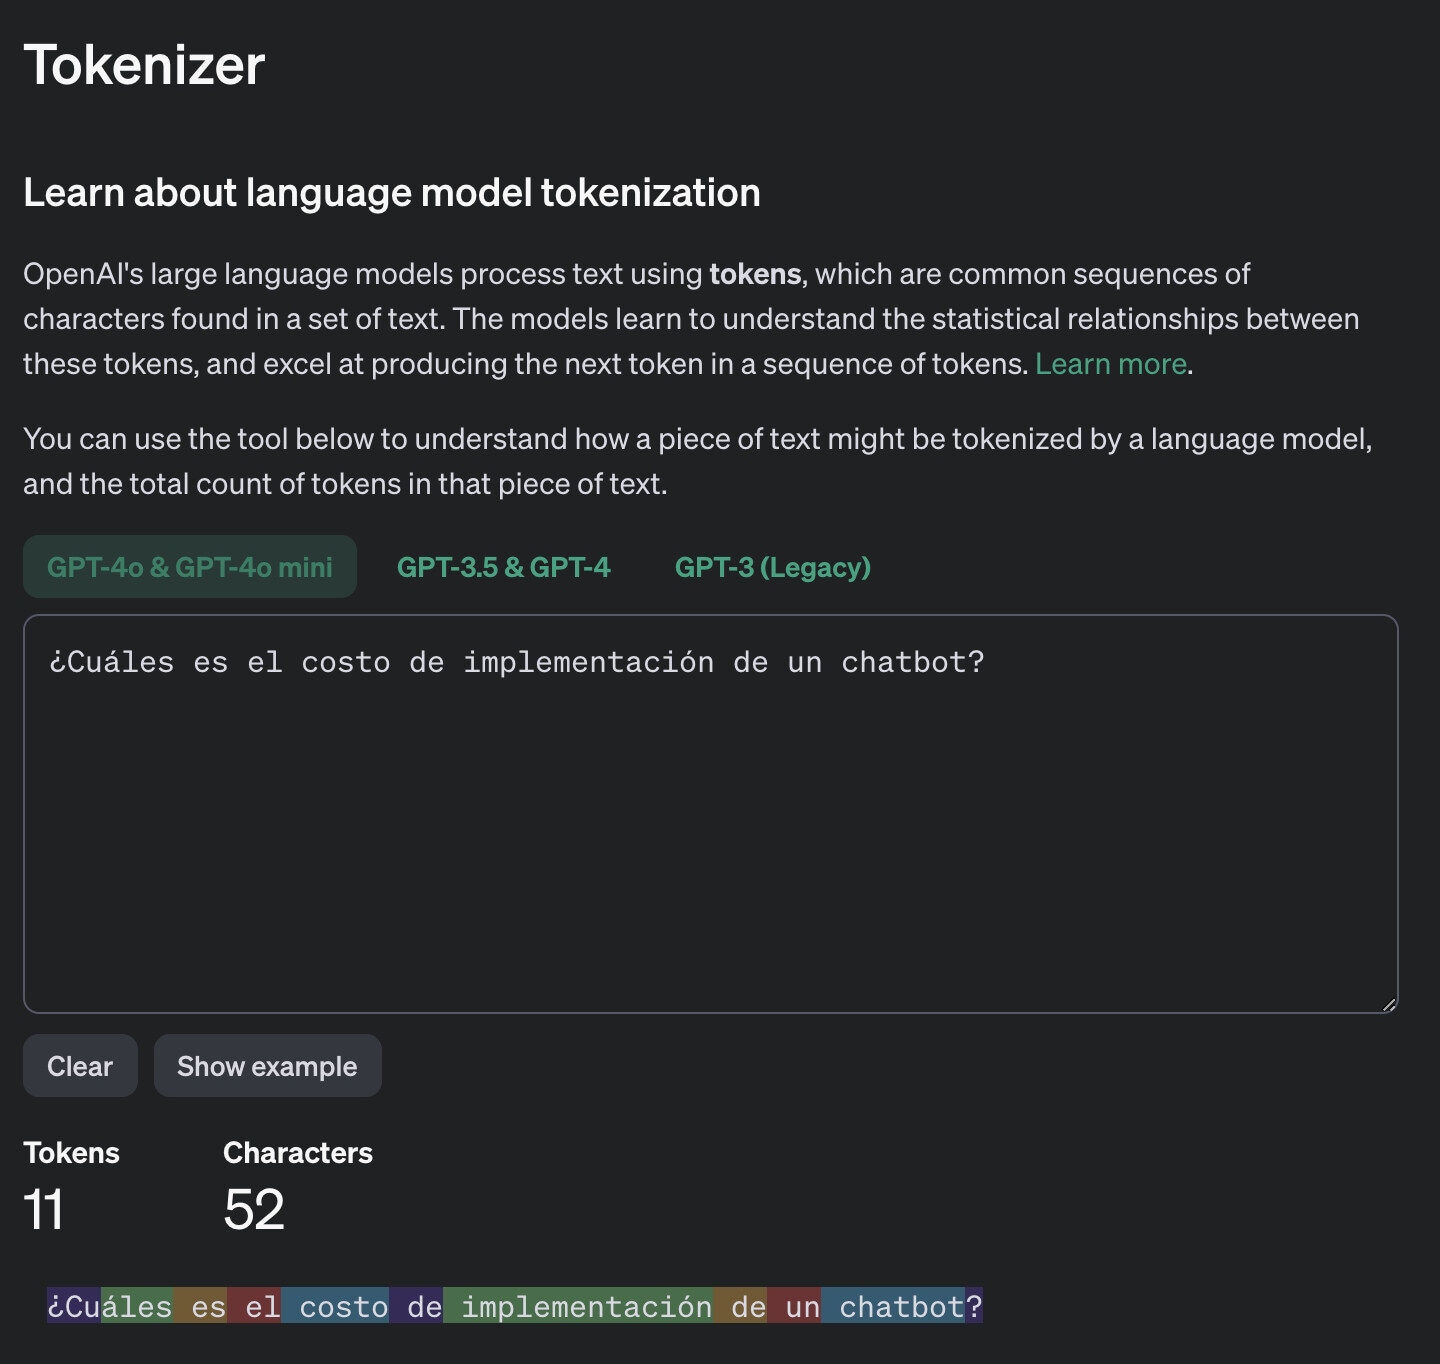
Un token es una unidad de texto que utiliza un modelo para procesar una entrada o generar una respuesta. No equivale exactamente a una palabra: una palabra puede ocupar uno o varios tokens, según el idioma y la forma en que está escrita.
En una conversación hay, como mínimo, dos tipos de consumo:
- Tokens de entrada: las instrucciones del sistema, el mensaje del usuario, el historial de conversación y el contexto que se envía al modelo.
- Tokens de salida: la respuesta que el modelo genera.
Si el agente consulta documentos con RAG, los fragmentos recuperados también forman parte de la entrada. Por eso una pregunta corta puede tener un consumo mayor si necesita mucho contexto para responder correctamente.
La fórmula básica para calcular el coste
Los proveedores suelen publicar una tarifa por millón o por mil tokens de entrada y otra distinta para tokens de salida. La fórmula es:
Coste por conversación =
(tokens de entrada / unidad de precio × tarifa de entrada) +
(tokens de salida / unidad de precio × tarifa de salida)
Por ejemplo, para estimar una conversación necesitas medir cuántos tokens recibe y genera el modelo, consultar la tarifa vigente del modelo elegido y aplicar la fórmula por separado para entrada y salida.
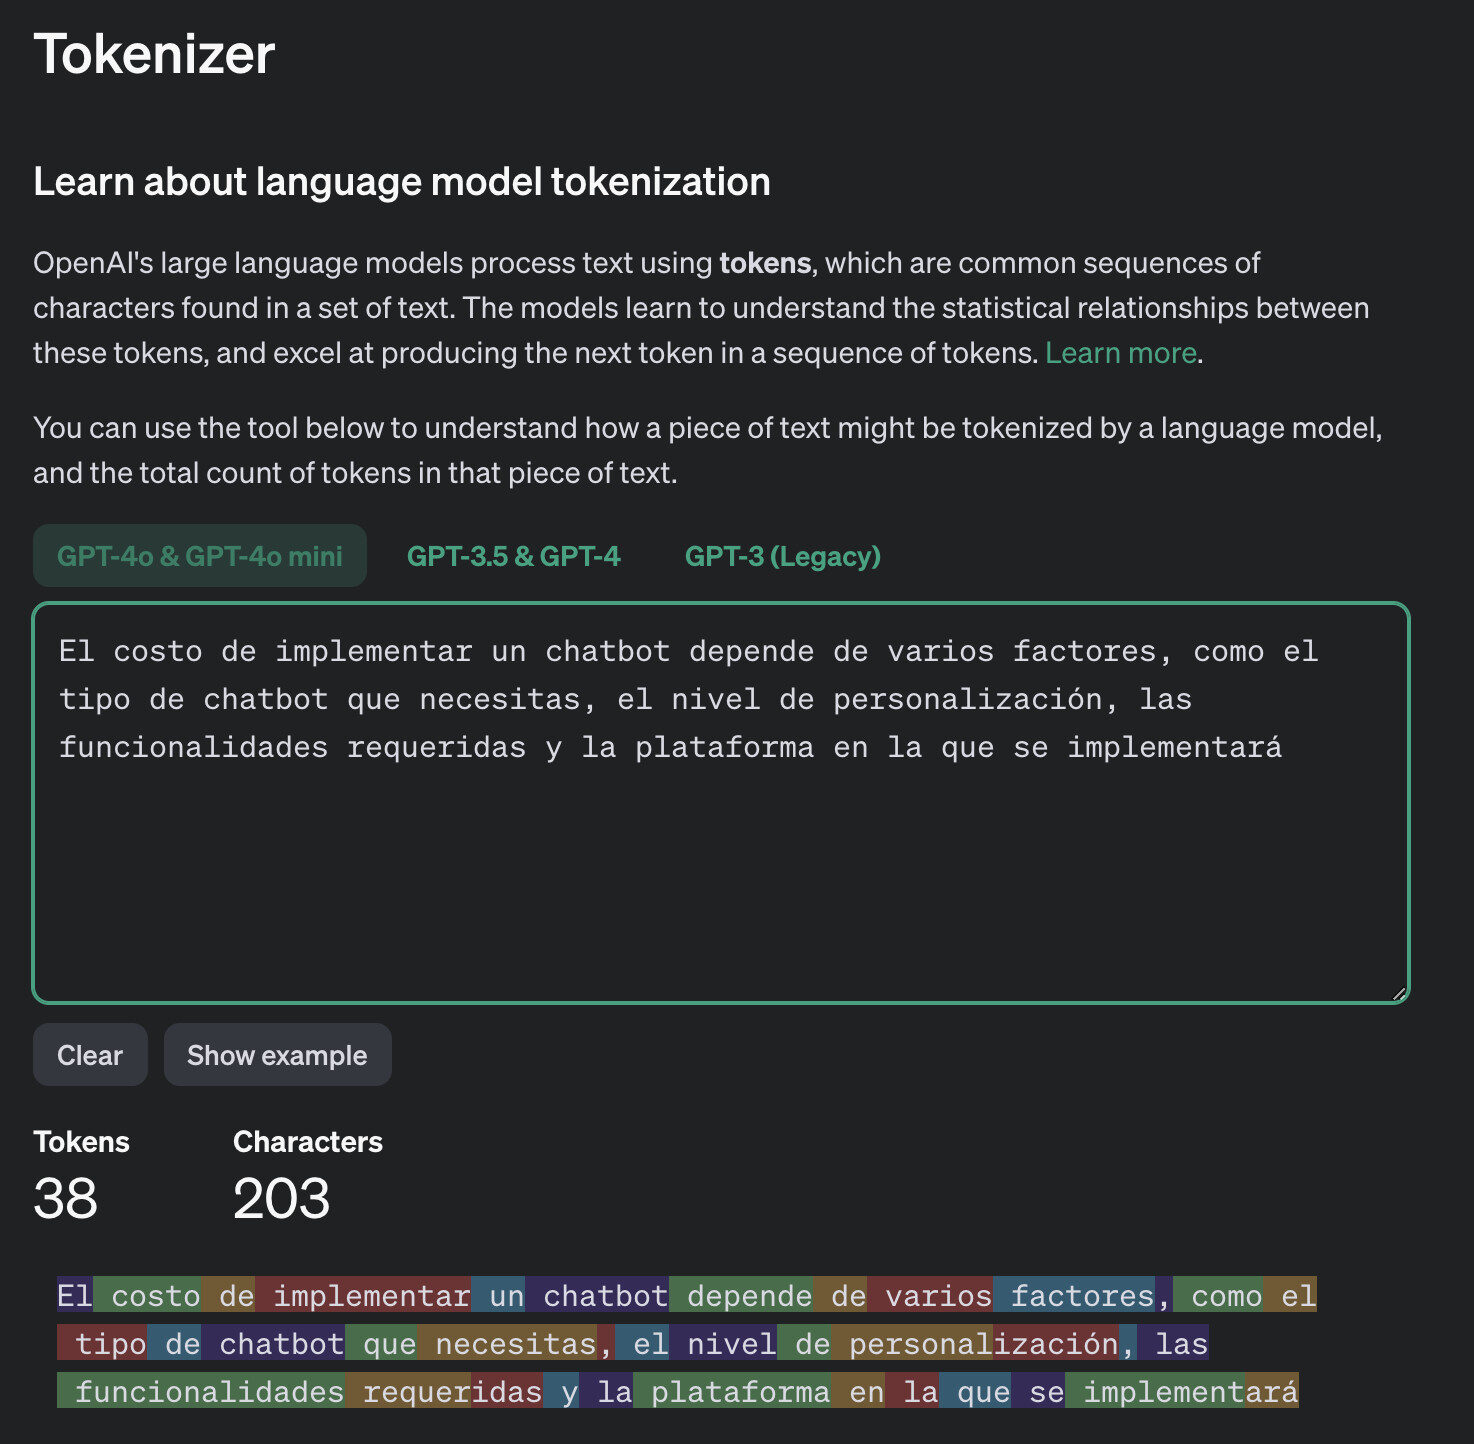
No uses una equivalencia fija entre caracteres y tokens para facturar o presupuestar. Sirve para una estimación rápida, pero el consumo real depende del idioma, el modelo, el historial y el contexto que envíes.
Qué suele aumentar el consumo
Historial de conversación demasiado largo
Conservar contexto ayuda al agente a responder de forma coherente, pero enviar todo el historial en cada turno aumenta los tokens de entrada. Conviene conservar solo los mensajes relevantes, resumir conversaciones largas o aplicar una ventana de contexto definida.
Instrucciones repetidas o extensas
Las instrucciones deben ser claras, pero no necesitan repetir reglas idénticas en varios lugares. Revisa el prompt del sistema, las políticas y las descripciones de herramientas para quitar redundancias.
Documentos RAG poco precisos
Recuperar muchos fragmentos no siempre mejora la respuesta. Si los documentos son extensos, duplicados o poco relacionados con la pregunta, aumentan el consumo y pueden reducir la calidad. Es preferible recuperar pocos fragmentos de alta relevancia.
Respuestas sin límite
Un agente que puede responder sin una longitud orientativa puede generar explicaciones innecesariamente largas. Define el nivel de detalle deseado para cada caso: una confirmación puede ser breve; una guía paso a paso necesita más contexto.
Cómo estimar el coste mensual
- Mide conversaciones reales o simuladas representativas.
- Registra los tokens medios de entrada y salida por conversación.
- Separa los flujos: soporte, captación, ventas, consultas con documentación y transferencias.
- Multiplica el coste medio de cada flujo por su volumen mensual esperado.
- Añade un margen para picos, pruebas y cambios de configuración.
Esta estimación es más útil que usar un único promedio para todo el negocio. Una conversación de cualificación simple no consume lo mismo que una consulta que revisa varios documentos y genera una propuesta detallada.
Cómo reducir costes sin empeorar la experiencia
- Elige el modelo en función de la complejidad real de cada tarea.
- Envía solo el contexto necesario para responder con precisión.
- Usa RAG con fuentes actualizadas y fragmentos bien organizados.
- Limita la extensión de respuestas que no requieren detalle.
- Registra uso, errores y conversaciones transferidas para ajustar el diseño.
- Mantén acciones sensibles y decisiones complejas bajo revisión humana.
El coste del modelo no es el único coste
Los tokens son una parte de la operación. También importan la calidad de la base de conocimiento, las integraciones, el seguimiento de conversaciones y el tiempo que el equipo dedica a mejorar el agente. Si el agente atiende en WhatsApp, conviene sumar además el precio de WhatsApp Business API y sus mensajes de servicio para calcular el coste completo por conversación — y antes de eso, la propia plataforma que eliges influye en ese coste total, como repasa esta comparativa de plataformas de chatbots con IA para empresas.
La buena pregunta no es solo cuánto cuesta un mensaje. Es cuánto valor aporta resolver una conversación de forma rápida, correcta y con el contexto adecuado.
Si quieres estimar el consumo de IA de tus conversaciones, Ceibot puede ayudarte a diseñar un caso de uso realista y medible.
Sigue aprendiendo
Posts relacionados
agentes de ia
Tu agente de IA no entiende cuando le preguntas por un código exacto
Por qué los agentes de IA basados en RAG fallan al buscar un SKU o código de referencia exacto, y cómo la búsqueda híbrida resuelve el problema sin afectar las preguntas en lenguaje natural.
Leer artículo: Tu agente de IA no entiende cuando le preguntas por un código exacto
agentes de ia
Alternativas a Twilio en 2026: cómo elegir la plataforma ideal para tu negocio
Por qué las empresas buscan alternativas a Twilio, cómo Ceibot conecta tu número a WhatsApp y a un agente de voz sin código, y 5 competidores más a considerar.
Leer artículo: Alternativas a Twilio en 2026: cómo elegir la plataforma ideal para tu negocio
agentes de ia
7 plataformas de chatbots con IA para empresas en 2026
Comparativa de las principales plataformas de chatbots con IA para empresas — criterios de evaluación, fortalezas de cada una y buenas prácticas de implementación.
Leer artículo: 7 plataformas de chatbots con IA para empresas en 2026


